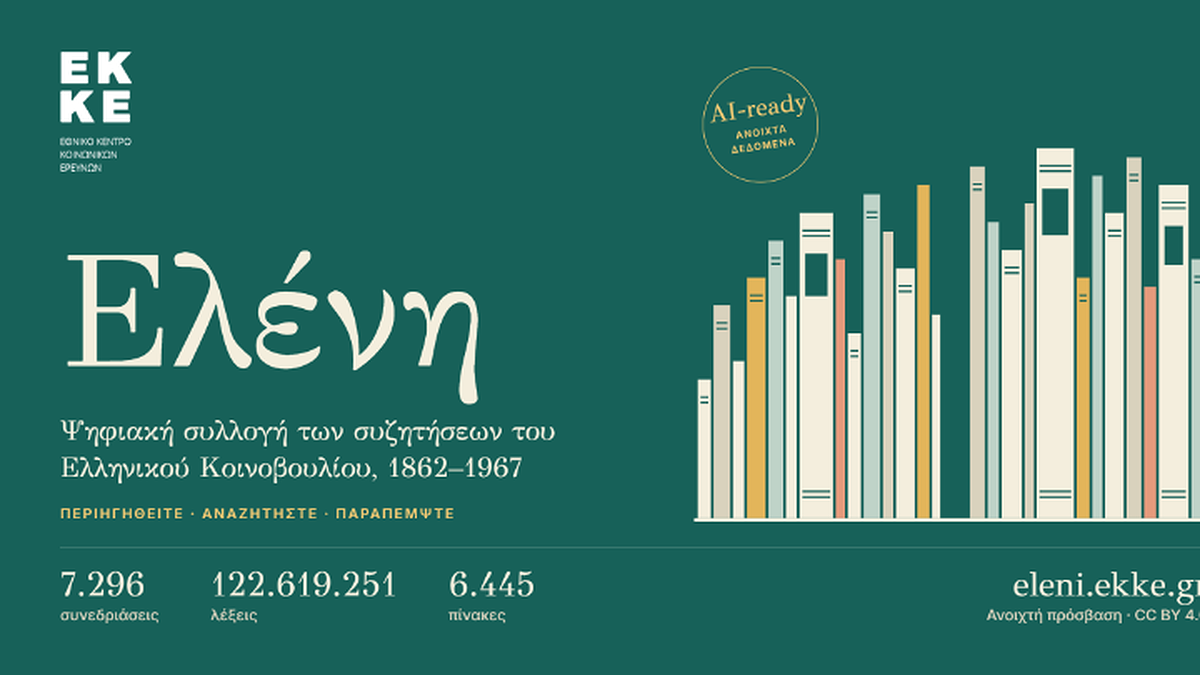
Με την «Ελένη», 123 εκατομμύρια λέξεις ελληνικής κοινοβουλευτικής ιστορίας βρίσκονται πλέον διαθέσιμες σε ένα κλικ. Η ψηφιακή συλλογή του ΕΚΚΕ ανοίγει το αρχείο των κοινοβουλευτικών πρακτικών από το 1862 έως το 1967 σε ερευνητές και κοινό.
Αν κάποιος αναζητήσει σήμερα στα πρακτικά της ελληνικής Βουλής τις λέξεις «φόρος», «σταφίδα» ή «δασμός», θα διαπιστώσει ότι η φορολογία δεν είναι μόνο μια σύγχρονη πολιτική αντιπαράθεση. Εδώ και περισσότερο από έναν αιώνα, οι Έλληνες βουλευτές αντάλλασσαν επιχειρήματα για το ποιο προϊόν έπρεπε να φορολογηθεί, ποιες περιοχές δικαιούνταν φοροαπαλλαγές και ποιος δασμός ήταν αναγκαίος ή υπερβολικός, ενώ οι διαφωνίες μπορούσαν να δημιουργήσουν εντάσεις ακόμη και στο εσωτερικό της ίδιας πολιτικής παράταξης.
Η ιστορία αυτών των συζητήσεων, μαζί με εκατομμύρια ακόμη λέξεις που καταγράφουν τις πολιτικές διαδρομές της χώρας, βρίσκεται πλέον σε απόσταση ενός κλικ. Δεν πρόκειται για μια ακόμη ψηφιακή βιβλιοθήκη, αλλά για μια ολοκληρωμένη ερευνητική υποδομή που επιτρέπει την αναζήτηση, την παρακολούθηση και τη μελέτη του ελληνικού κοινοβουλευτικού λόγου από το 1862 έως το 1967.
Πρόκειται για την «Ελένη», την ψηφιακή συλλογή του Εθνικού Κέντρου Κοινωνικών Ερευνών (ΕΚΚΕ), η οποία συγκεντρώνει 7.296 συνεδριάσεις και περισσότερες από 123 εκατομμύρια λέξεις, διαθέτοντας το υλικό ελεύθερα στο κοινό και στην ερευνητική κοινότητα, με ανοικτά δεδομένα.
Πίσω από το εγχείρημα βρίσκεται ο Πάρις Ασλανίδης, Εντεταλμένος Ερευνητής στο ΕΚΚΕ. Η «Ελένη» ξεκίνησε ως πρακτικό εργαλείο για τις ανάγκες της δικής του μεταδιδακτορικής έρευνας και εξελίχθηκε σε μια προσπάθεια διάσωσης, οργάνωσης και ελεύθερης διάθεσης ενός τεράστιου όγκου ιστορικού υλικού. Η διαδρομή αυτή συνδύασε αρχειακή έρευνα, πολιτική ιστορία, προγραμματισμό και τις δυνατότητες της τεχνητής νοημοσύνης.
Από την έρευνα για τον λαϊκισμό στη δημιουργία της «Ελένης»
Η αφετηρία ήταν η μεταδιδακτορική έρευνα του Πάρι Ασλανίδη στο Εθνικό Κέντρο Κοινωνικών Ερευνών, με υποτροφία Marie Skłodowska-Curie της Ευρωπαϊκής Ένωσης, και αντικείμενο την εξέλιξη του λαϊκιστικού λόγου στην Ελλάδα.
«Στην πορεία ανακάλυψα ότι το διαθέσιμο ψηφιοποιημένο υλικό είχε πολλά κενά και άλλα τεχνικά προβλήματα, και αποφάσισα να φτιάξω μια νέα βάση δεδομένων, από το μηδέν. Σύντομα συνειδητοποίησα τον πλούτο που έκρυβε αυτό το υλικό και το πόσο χρήσιμο θα ήταν να το διαθέσω ελεύθερα στην ερευνητική κοινότητα και στο ευρύ κοινό. Εκτός από τη βάση δεδομένων, δημιούργησα και έναν ιστότοπο για την περιήγηση και την αναζήτηση στο υλικό, και κάπως έτσι γεννήθηκε η Ελένη», εξηγεί ο κ. Ασλανίδης.
Το όνομα, πάντως, έχει τη δική του μικρή ιστορία. Ο δημιουργός της δεν ήθελε να καταφύγει σε ένα στεγνό ακρωνύμιο ή σε μια απρόσωπη ονομασία και είχε αφήσει το ζήτημα της ονοματοδοσίας για αργότερα. «Όταν η ψηφιοποίηση έφτασε στο 1953 κι έπεσα επάνω στο πρώτο γυναικείο όνομα στη βάση μου, την Ελένη Σκούρα, την πρώτη Ελληνίδα βουλευτή, που εξελέγη στη Θεσσαλονίκη με τον Ελληνικό Συναγερμό, άρχισαν να μου μπαίνουν ιδέες. Ελένη τυχαίνει να είναι και το όνομα της κόρης μου, αλλά και της μητέρας μου. Δεν ξέρω αν το όνομα τελικά τιμά περισσότερο την είσοδο των γυναικών στα πολιτικά δρώμενα της χώρας ή το οικογενειακό μου δέντρο, αλλά, σε κάθε περίπτωση, νομίζω ότι είναι ένα σύντομο, όμορφο και ταιριαστό όνομα για ένα τέτοιο έργο», αναφέρει.
Ένα εγχείρημα που απαιτούσε ιστορική γνώση, τεχνικές δεξιότητες και αρκετή επιμονή
Η δημιουργία μιας τέτοιας ψηφιακής υποδομής δεν είναι υπόθεση ενός μόνο γνωστικού αντικειμένου. Απαιτεί συνδυασμό τεχνικών και ερευνητικών δεξιοτήτων, από την αρχειακή έρευνα και τη γνώση της πολιτικής ιστορίας μέχρι την επεξεργασία εικόνας, τη συγγραφή κώδικα και την εξοικείωση με τις βασικές αρχές της τεχνητής νοημοσύνης.
Ο Πάρις Ασλανίδης στάθηκε, όπως λέει, τυχερός, καθώς η δημιουργία της «Ελένης» συνέπεσε με την εντυπωσιακή εξέλιξη των μεγάλων γλωσσικών μοντέλων τεχνητής νοημοσύνης (LLMs). Το προσωπικό του υπόβαθρο -απόφοιτος Πολυτεχνικής Σχολής και πρώην μηχανικός υπολογιστικών συστημάτων στον ιδιωτικό τομέα- του έδωσε ένα σημαντικό προβάδισμα. Ωστόσο, όπως τονίζει: «Πάνω από όλα όμως, ένα έργο σαν την Ελένη απαιτεί μεράκι και αφοσίωση, για να μην πω έναν βαθμό εμμονής».
Και πράγματι, η συγκέντρωση του υλικού αποδείχθηκε εξαιρετικά απαιτητική. «Από την αρχή έβαλα σκοπό να εντοπίσω και να συμπεριλάβω κάθε γραμμή της Εφημερίδας των Συζητήσεων της Βουλής που έλειπε από την ψηφιακή συλλογή της Βουλής των Ελλήνων. Τα κενά ήταν περισσότερα από ό,τι νόμιζα. Χρειάστηκαν δεκάδες επισκέψεις σε βιβλιοθήκες της Αθήνας για να συμπληρώσω σελίδες που έλειπαν, ήταν τσακισμένες, σκισμένες ή είχαν αχνή ή θολή τύπωση, αλλά και ολόκληρους τόμους, που βρήκα κατά τύχη σε μέρη όπου δεν το περίμενα: στη Δημοτική Βιβλιοθήκη Αθηνών, στο Πολεμικό Μουσείο ή στη βιβλιοθήκη των Γενικών Αρχείων του Κράτους», σημειώνει.
Η περιγραφή του αποκαλύπτει μια σχεδόν κινηματογραφική διάσταση της αρχειακής αναζήτησης: «Πέρασα πάρα πολλές ώρες όρθιος να φωτογραφίζω παλιούς και σκοροφαγωμένους τόμους με το κινητό μου ή να ψάχνω τον τάδε τόμο που μου έλειπε, ως Άγιο Δισκοπότηρο, σε σκονισμένα βιβλιοστάσια, όποτε οι βιβλιοθηκονόμοι μου έκαναν τη χάρη να με αφήσουν να επισκεφτώ τις αποθήκες της συλλογής τους».
Η τεχνητή νοημοσύνη απέναντι στην καθαρεύουσα και στο πολυτονικό
Αν η συγκέντρωση του πρωτογενούς υλικού ήταν το πρώτο μεγάλο εμπόδιο, η απόφαση να πραγματοποιηθεί η αναγνώριση των χαρακτήρων από την αρχή εκτόξευσε τον βαθμό δυσκολίας.
«Οι κλασικές μέθοδοι OCR δεν δούλευαν καθόλου καλά: μιλάμε για κείμενα στο πολυτονικό, με πολύ κακή ποιότητα εκτύπωσης, όπως καταλαβαίνετε, αφού φτάνουν πίσω ως το 1862. Ευτυχώς, εδώ βοήθησε η τεχνητή νοημοσύνη, και συγκεκριμένα τα μοντέλα Gemini της Google, που διαβάζουν πολύ καλά την καθαρεύουσα και μπορούν να αποκαταστήσουν για παράδειγμα έναν χαρακτήρα που είναι αχνός από τα συμφραζόμενα», εξηγεί ο ερευνητής.
Το αποτέλεσμα της αρχικής αναγνώρισης ήταν εντυπωσιακό, αλλά είχε ακόμη προβλήματα. «Για να τα λύσω, έγραψα δεκάδες χιλιάδες γραμμές κώδικα Python (και εδώ βοήθησε βέβαια η τεχνητή νοημοσύνη) ώστε να καθαρίσω το υλικό. Χρειάστηκε όμως και πολύ “χέρι”: μήνες ολόκληροι όπου ο κώδικας έπρεπε να συνδυαστεί με δικές μου αποφάσεις, λέξη προς λέξη. Η δημιουργία του ίδιου του ιστότοπου της Ελένης στο eleni.ekke.gr ήταν μάλλον το πιο εύκολο κομμάτι της όλης διαδικασίας», παραδέχεται.
Ο ανεξάντλητος πλούτος των κοινοβουλευτικών πρακτικών και οι διαχρονικές πολιτικές αντιπαραθέσεις
Η μεγαλύτερη έκπληξη για τον δημιουργό της «Ελένης» ήταν ο ερευνητικός και πολιτισμικός πλούτος που κρύβεται στο υλικό: «Το υλικό που είναι πια στη διάθεση ιστορικών, πολιτικών επιστημόνων, κοινωνιολόγων, λαογράφων, γλωσσολόγων και πολλών άλλων ερευνητών είναι πραγματικά ανεξάντλητο. Πέρα από αυτά, η ανάγνωση, ειδικά των παλαιότερων συνεδριάσεων, είναι και άκρως απολαυστική».
Τι μπορεί, όμως, να αποκαλύψει αυτό το τεράστιο σώμα κειμένων για την ελληνική κοινωνία από το 1862 έως το 1967; Ο κ. Ασλανίδης εφιστά την προσοχή: «Πιο ταιριαστό, νομίζω, είναι να ερευνήσουμε το τι αποκαλύπτουν για το πολιτικό μας προσωπικό, παρά για την ίδια την κοινωνία. Ο κοινοβουλευτικός λόγος είναι εξ ορισμού λόγος που εκφέρεται από τις πολιτικές ελίτ και θα είναι λάθος να υποθέσουμε ότι αντικατοπτρίζει αναγκαστικά το τι γίνεται στην κοινωνία. Απαιτείται λοιπόν πολλή έρευνα για να φτάσουμε σε ασφαλή συμπεράσματα, αλλά αυτός είναι ακριβώς και ο σκοπός ύπαρξης της Ελένης. Να βοηθήσει την έρευνα, κάνοντάς το υλικό ευρέως διαθέσιμο και εύκολα αναζητήσιμο. Τώρα πια, δεν υπάρχουν δικαιολογίες – η ιστορία του κοινοβουλευτικού μας λόγου είναι ένα κλικ μακριά».
Και αν υπάρχει ένα θέμα που επιβεβαιώνει τη διαχρονικότητα των πολιτικών αντιπαραθέσεων, αυτό είναι η φορολογία. «Η φορολόγηση του παραμικρού προϊόντος, και βέβαια των σημαντικών εμπορικών προϊόντων όπως η σταφίδα, απασχολεί το κοινοβούλιο διαχρονικά και αποτελεί σημείο εντάσεως και τριβής ακόμα και ανάμεσα σε βουλευτές του ίδιου κόμματος. Υπάρχουν δεκάδες χιλιάδες αναφορές, ολόκληρες συνεδριάσεις αφιερωμένες στο ερώτημα τι φόρος (αλλά και δασμός) πρέπει ή δεν πρέπει να μπει στο τάδε προϊόν, ή γιατί η δείνα περιοχή της επικράτειας δικαιούται φοροαπαλλαγών και φοροελαφρύνσεων», υπογραμμίζει.
Τι μπορεί να κάνει κανείς με την «Ελένη»
Η αξία της ψηφιακής συλλογής δεν περιορίζεται στον όγκο του υλικού, αλλά επεκτείνεται και στις δυνατότητες αξιοποίησής του. Ο χρήστης μπορεί να αναζητήσει οποιαδήποτε λέξη ή φράση σε ολόκληρο το σώμα των κειμένων, να παρακολουθήσει τη διασπορά των εμφανίσεών της στο χρονολόγιο και να εντοπίσει όλες τις παρεμβάσεις ενός ομιλητή ή μιας ομιλήτριας.
Για κάθε συνεδρίαση, παρέμβαση ή στίχο δίνεται μόνιμος ηλεκτρονικός σύνδεσμος, έτοιμη βιβλιογραφική αναφορά, καθώς και δύο αυτόματες συνόψεις ανά συνεδρίαση. Οι χρήστες μπορούν να κατεβάσουν αποσπάσματα, ολόκληρες συνεδριάσεις ή πλήρεις συνόδους, ενώ οι πίνακες εξάγονται σε μορφές CSV ή Markdown. Για πιο σύνθετες υπολογιστικές εφαρμογές, ολόκληρη η συλλογή διατίθεται με άδεια Creative Commons CC BY 4.0 ως ενιαίο σύνολο δεδομένων με DOI στο αποθετήριο Hugging Face (http://doi.org/10.57967/hf/11475).
Η τεχνητή νοημοσύνη ως ερευνητικός συνεργάτης: οι δυνατότητες και οι παγίδες
Η συμβολή της τεχνητής νοημοσύνης στη δημιουργία της «Ελένης» υπήρξε πολυεπίπεδη: χρησιμοποιήθηκε στην αναγνώριση χαρακτήρων, στη συγγραφή κώδικα Python, στη δημιουργία της ιστοσελίδας, καθώς και στην παραγωγή συνόψεων μέσω δύο διαφορετικών γλωσσικών μοντέλων.
«Τα συμπεράσματά μου μετά από αυτά τα 2-2.5 χρόνια τριβής, είναι ότι η τεχνητή νοημοσύνη μπορεί ξεκάθαρα να βοηθήσει την έρευνα, τόσο από πλευράς κατασκευής ερευνητικών υποδομών όπως η Ελένη, αλλά και στην ανάλυση των δεδομένων. Δεν νομίζω ότι η διαδικασία αυτή μπορεί να σταματήσει, παρά τους κινδύνους που ελλοχεύουν όταν η τεχνητή νοημοσύνη χρησιμοποιηθεί όχι ως βοηθός που αυξάνει την αποδοτικότητά μας, αλλά ως ένα εργαλείο μαζικής παραγωγής ερευνητικού αποτελέσματος δίχως πραγματικό επιστημονικό αντίκτυπο», επισημαίνει ο κ. Ασλανίδης.
Ο μεγαλύτερος κίνδυνος συνδέεται με την πίεση των δημοσιεύσεων: «Το άγχος του ερευνητή ή της ερευνήτριας να δημοσιεύσει όσο το δυνατόν περισσότερα πονήματα στον λιγότερο δυνατό χρόνο… μπορεί να οδηγήσει στις μέρες μας σε μία ρηχή χρήση της τεχνητής νοημοσύνης, όπου αφήνεται το μοντέλο να κάνει όλη τη δουλειά, από τη σύλληψη μιας ιδέας ως την τελική συγγραφή. Δυστυχώς έχουμε αρχίσει να το βλέπουμε αυτό ήδη δεξιά και αριστερά».
Υπάρχει, ωστόσο, και το άλλο άκρο: «Η πεισματική άρνηση χρήσης της τεχνητής νοημοσύνης και η προσπάθεια απαγόρευσης χρήσης των σχετικών εργαλείων στην έρευνα… μου θυμίζει καθηγητές στα τέλη της δεκαετίας του 1990 που μας απαγόρευαν να χρησιμοποιούμε πηγές “από το ίντερνετ”, περιορίζοντάς μας σε ό,τι περιείχε στη συλλογή της η πανεπιστημιακή μας βιβλιοθήκη. Η μέση οδός είναι το ζητούμενο, δηλαδή η λελογισμένη και δημιουργική χρήση της τεχνητής νοημοσύνης στην επιστημονική έρευνα. Αυτά, όταν μιλάμε για ανθρωπιστικές και κοινωνικές επιστήμες. Στις “σκληρές” επιστήμες, τα πράγματα είναι απείρως πιο περίπλοκα».
Η ακρίβεια της ιστορικής πηγής και τα λάθη που ταξιδεύουν μέσα στον χρόνο
Όταν το αντικείμενο μιας ψηφιακής συλλογής είναι ιστορικά έγγραφα, η αξιοπιστία των κειμένων είναι καθοριστική. «Εργάστηκα πολύ σκληρά πάνω σε αυτό και, αν και σίγουρα θα υπάρχουν ακόμη κάποια λάθη, μπορώ να δηλώσω ότι η βάση είναι κατά 99,9% σωστή, με τα εναπομείναντα σφάλματα να είναι επουσιώδη. Το τι βέβαια αποτελεί ή δεν αποτελεί “σφάλμα” σηκώνει μεγάλη συζήτηση», σημειώνει ο δημιουργός της.
Όπως εξηγεί, μια λέξη που εκφωνήθηκε το 1862 στο κτίριο της Παλαιάς Βουλής διένυσε ένα μακρύ ταξίδι μέχρι την ηλεκτρονική της καταγραφή: «Καταρχήν, έχουμε το πιθανό λάθος του στενογράφου που κατέγραψε την ομιλία, το λάθος κατά τη διάρκεια της μεταγραφής των στενογραφημένων σημειώσεων σε ρέον κείμενο, το λάθος του στοιχειοθέτη στο τυπογραφείο της εποχής, ή ακόμη και την συνειδητή του επιλογή να χρησιμοποιήσει π.χ. ένα αντεστραμμένο στοιχείο ῖ αντί για το ι, καθώς του είχαν τελειώσει τα αντίστοιχα μολύβδινα στοιχεία (κάτι που μάλλον συνέβαινε συχνά). Έχουμε ακόμη το λάθος του τυπογράφου, που “πήδηξε” δύο σελίδες ή τύπωσε άλλες σε λάθος σειρά, ένα λάθος που μπορεί κάλλιστα να διαπράξει αργότερα και ο βιβλιοδέτης».
Ο Ασλανίδης εντόπισε και διόρθωσε χιλιάδες τέτοιες περιπτώσεις, ενώ αντιμετώπισε τα σφάλματα του OCR μέσω δεκάδων scripts σε Python που σχεδίασε για να διορθώσει τις παρατυπίες του μοντέλου Gemini. «Πιστεύω ακράδαντα στην ποιότητα του τελικού αποτελέσματος, αλλά σε κάθε περίπτωση θα συνεχίσω να κάνω τις απαραίτητες διορθώσεις όποτε κάτι πέφτει στην αντίληψή μου», καταλήγει.
Από το ιστορικό αρχείο στην επόμενη γενιά της έρευνας
Η «Ελένη» δημιουργήθηκε από τον Πάρι Ασλανίδη στο πλαίσιο του ερευνητικού έργου GREEKPOP, των δράσεων Marie Skłodowska-Curie του προγράμματος Horizon Europe, και φιλοξενείται μόνιμα από το ΕΚΚΕ.
Η σημασία της δεν εξαντλείται στην ψηφιοποίηση ενός τεράστιου όγκου κοινοβουλευτικών πρακτικών, αλλά και στη δυνατότητα να μετατρέψει ένα υλικό που για δεκαετίες απαιτούσε φυσική παρουσία σε βιβλιοθήκες και επίπονη αναζήτηση σε μια ανοιχτή, αναζητήσιμη και αξιοποιήσιμη ερευνητική πηγή. Από τις φορολογικές διαμάχες για τη σταφίδα μέχρι την παρουσία των πρώτων γυναικών στη Βουλή και τις μεταβολές της πολιτικής γλώσσας, οι κοινοβουλευτικές συζητήσεις δημιουργούν τις προϋποθέσεις για νέα ερευνητικά ερωτήματα.
Η ιστορία του ελληνικού κοινοβουλευτικού λόγου, από το 1862 έως το 1967, δεν είναι πλέον κλεισμένη στις σελίδες παλιών τόμων. Είναι διαθέσιμη σε ερευνητές, φοιτητές και πολίτες, έτοιμη να διαβαστεί και να αναλυθεί, με μία απλή αφετηρία: ένα κλικ.
Η «Ελένη» είναι διαθέσιμη στη διεύθυνση: http://eleni.ekke.gr
*Τις φωτογραφίες παραχώρησε ο Πάρις Ασλανίδης