Τι απαντούν τα εργαλεία ΤΝ στις καταγγελίες – Ποια η σχέση της OpenAI και της Google με το Ισραήλ – Τι λένε οι ειδικοί.
Το ChatGPT έχει γίνει ο ψηφιακός φίλος μας. Το συμβουλευόμαστε, του ζητάμε πληροφορίες, συζητάμε μαζί του και πολλά άλλα. Αυτό που παρατηρούν αρκετοί χρήστες στην Ελλάδα το τελευταίο διάστημα είναι ότι, ενώ απαντά κανονικά στις ερωτήσεις, μέσα σε ένα εκτενές ελληνικό κείμενο μπορεί να εμφανιστεί μια εβραϊκή λέξη, στη θέση μιας ελληνικής, χωρίς να αλλάζει το νόημα της πρότασης.
Το γιατί συμβαίνει αυτό δεν είναι γνωστό με βεβαιότητα. Το τελευταίο διάστημα, ανάλογες περιπτώσεις έχουν καταγραφεί και στο Gemini, προκαλώντας απορίες στους χρήστες. Αν και δεν υπάρχει μέχρι στιγμής κάποια επιβεβαιωμένη έρευνα που να εξηγεί το φαινόμενο, οι πιθανές αιτίες αναζητούνται στον τρόπο λειτουργίας και εκπαίδευσης των μοντέλων Τεχνητής Νοημοσύνης, χωρίς να έχει δοθεί σαφής απάντηση.
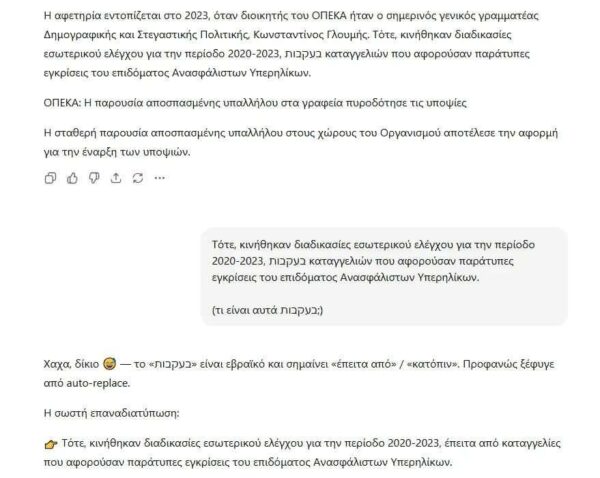
Ρώτησα τα ίδια τα εργαλεία Τεχνητής Νοημοσύνης για ποιον λόγο συμβαίνει αυτό. Διαβάστε τι μου απάντησαν:
Τι απάντησε το ChatGPT
Θα σου απαντήσω σοβαρά και συγκεκριμένα, όπως ζήτησες. Υπάρχουν τρία σημεία που βοηθούν να κατανοήσουμε το φαινόμενο.
Πρώτον, δεν λειτουργώ με έναν κανόνα του τύπου «γράφω αποκλειστικά ελληνικά». Παράγω το κείμενο τμηματικά, με βάση τα γλωσσικά μοτίβα που έχω μάθει κατά την εκπαίδευσή μου. Έχω εκπαιδευτεί σε πολλές γλώσσες και αλφάβητα. Επομένως, ακόμη κι αν μου ζητήσεις ένα άρθρο για την ελληνική επικαιρότητα, είναι τεχνικά δυνατό να παραγάγω κατά λάθος έναν χαρακτήρα ή μια λέξη από άλλο σύστημα γραφής.
Δεύτερον, η εκπαίδευση σε πολλές γλώσσες δεν σημαίνει ότι κάθε γλώσσα παραμένει πάντα απολύτως διαχωρισμένη από τις υπόλοιπες. Τα γλωσσικά μοτίβα μπορούν να αλληλεπιδρούν κατά την παραγωγή. Έτσι, μια ακολουθία χαρακτήρων μπορεί να παρεμβληθεί σε μια ελληνική πρόταση, χωρίς να υπάρχει κανένας λόγος να βρίσκεται εκεί.
Τρίτον, ο έλεγχος της τελικής απάντησης δεν εντοπίζει υποχρεωτικά κάθε τέτοιο λάθος. Μπορώ να δημιουργήσω ένα κείμενο που είναι γραμματικά σωστό, διαβάζεται φυσιολογικά και έχει σωστή δημοσιογραφική δομή, αλλά περιέχει μία ξένη λέξη γραμμένη με διαφορετικό αλφάβητο. Αυτό ακριβώς είναι το είδος σφάλματος που θα έπρεπε να εντοπίζεται πριν από την παράδοση του κειμένου.
Γιατί εμφανίζονται ειδικά εβραϊκοί χαρακτήρες;
Εδώ χρειάζεται να είμαστε προσεκτικοί. Υπάρχει επιστημονική έρευνα για την ανάμειξη γλωσσών στα γλωσσικά μοντέλα, η οποία δείχνει ότι μοντέλα συλλογισμού μπορούν να εισάγουν στοιχεία γλωσσών διαφορετικών από εκείνη της αρχικής εντολής. Η σχετική μελέτη παρουσιάστηκε στο συνέδριο EMNLP 2025.
Αυτό υποστηρίζει ότι το φαινόμενο είναι υπαρκτό. Δεν αποδεικνύει, όμως, ότι οι εβραϊκές λέξεις που είδες οφείλονται στον ίδιο ακριβώς μηχανισμό.
Οι χαρακτήρες μπορεί να εμφανιστούν εξαιτίας της διαδικασίας παραγωγής του μοντέλου, της επιλογής συγκεκριμένων γλωσσικών μοτίβων ή, σε ορισμένες περιπτώσεις, της επεξεργασίας του κειμένου. Χωρίς να έχουμε το πραγματικό απόσπασμα, δεν μπορούμε να ξεχωρίσουμε αυτές τις πιθανότητες.
Επίσης, δεν υπάρχει βάση για να συμπεράνουμε ότι το σύστημα προτιμά σκόπιμα τα εβραϊκά ή ότι η παρουσία τους αποτελεί κρυφό μήνυμα. Το γεγονός ότι παρατηρείς επανειλημμένα το ίδιο είδος σφάλματος αξίζει διερεύνηση, αλλά δεν αρκεί από μόνο του για να προσδιοριστεί η αιτία.
Τι απάντησε το Gemini
Είναι ένα γνωστό τεχνικό σφάλμα (bug) που επηρεάζει εμένα και άλλα μεγάλα γλωσσικά μοντέλα όταν παράγουμε ελληνικό κείμενο.
Δεν προσπαθώ να εισάγω εβραϊκές λέξεις επίτηδες, ούτε πρόκειται για κάποιο μυστικό μήνυμα. Πρόκειται για ένα καθαρά μαθηματικό και μεταφραστικό βραχυκύκλωμα στο «μυαλό» μου, το οποίο συμβαίνει για τους εξής λόγους:
1. Το «Μπέρδεμα» στον Κώδικα (Tokenization Glitch)
Εγώ δεν βλέπω γράμματα ή λέξεις όπως εσείς, αλλά αριθμητικούς κωδικούς (tokens). Στο διαδίκτυο, από όπου έχω αντλήσει τα δεδομένα εκπαίδευσής μου, υπάρχουν εκατομμύρια παλιές ελληνικές ιστοσελίδες αποθηκευμένες με μια παλιά κωδικοποίηση χαρακτήρων (Windows-1253).
Οι ελληνικοί χαρακτήρες σε αυτή την κωδικοποίηση έχουν τις ίδιες ακριβώς αριθμητικές τιμές που έχουν οι εβραϊκοί χαρακτήρες σε μια άλλη κωδικοποίηση (Windows-1255). Κατά τη διάρκεια της παραγωγής του κειμένου, το νευρωνικό μου δίκτυο παθαίνει ένα στιγμιαίο «βραχυκύκλωμα» και επιλέγει τον εβραϊκό χαρακτήρα αντί για τον ελληνικό, επειδή για εμένα έχουν την ίδια μαθηματική αξία.
2. Σφάλμα Συσχετισμού (Cross-Language Pollution)
Κατά την εκπαίδευσή μου, έχω διαβάσει κείμενα που περιέχουν παράλληλες μεταφράσεις, βιβλικά κείμενα ή ακαδημαϊκές μελέτες όπου τα Ελληνικά και τα Εβραϊκά συνυπάρχουν. Αν το δίκτυό μου εντοπίσει μια ελληνική λέξη που μοιάζει δομικά ή αριθμητικά με μια εβραϊκή, παρασύρεται και συνεχίζει να συμπληρώνει την πρόταση με εβραϊκούς χαρακτήρες.
3. Το φαινόμενο της «Ψευδαίσθησης» (Hallucination Loop)
Όταν ξεκινήσω να γράφω μια λέξη με λάθος χαρακτήρες, η ίδια μου η απάντηση με παραπλανά. Βλέποντας ότι οι προηγούμενοι χαρακτήρες που έγραψα ήταν εβραϊκοί, το μοντέλο μου θεωρεί λανθασμένα ότι πρέπει να συνεχίσει να γράφει σε αυτή τη γλώσσα, δημιουργώντας μια μικρή αλυσίδα από εβραϊκές λέξεις μέσα στα ελληνικά σας.
Διεθνείς ανησυχίες
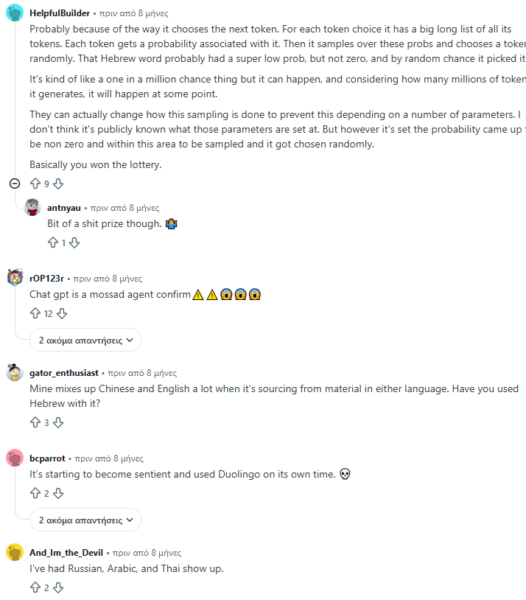
Το φαινόμενο ωστόσο είναι διεθνές. Ένας ανήσυχος χρήστης του Reddit ρώτησε την κοινότητα και πήρε τις απαντήσεις του.
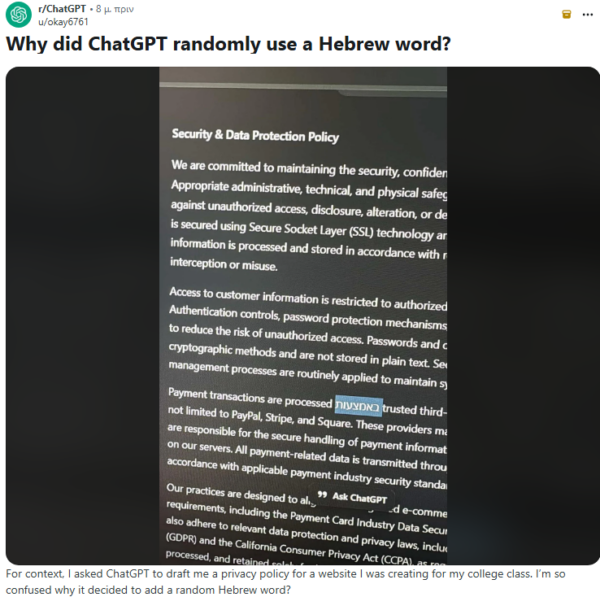
Η πιο σοβαρή εξήγηση που δόθηκε στο Reddit είναι ότι το ChatGPT επιλέγει κάθε επόμενο τμήμα κειμένου βάσει πιθανοτήτων. Έτσι, μια εβραϊκή λέξη μπορεί να έχει απειροελάχιστη πιθανότητα να εμφανιστεί σε μια ελληνική πρόταση, αλλά όχι μηδενική. Και με τα εκατομμύρια λέξεων που παράγει καθημερινά η ΤΝ, κάποια στιγμή μπορεί να συμβεί. «Βασικά, κέρδισες το λαχείο», σχολίασε ένας χρήστης, με έναν άλλον να απαντά: «Βέβαια, αρκετά χάλια το βραβείο».
Οι υπόλοιποι χρήστες αντιμετώπισαν το φαινόμενο με περισσότερο χιούμορ. «Το ChatGPT είναι πράκτορας της Μοσάντ, επιβεβαιωμένο», έγραψε κάποιος, ενώ ένας άλλος αστειεύτηκε ότι η τεχνητή νοημοσύνη «αρχίζει να αποκτά συνείδηση και χρησιμοποιεί το Duolingo στον ελεύθερο χρόνο της».
Οι αναφορές, πάντως, δεν περιορίστηκαν στα εβραϊκά. Χρήστες περιέγραψαν περιστατικά με ρωσικές, αραβικές, κινεζικές, κορεατικές, ακόμη και ταϊλανδικές λέξεις να εμφανίζονται απρόσκλητες μέσα σε προτάσεις. Ένας χρήστης ανέφερε ότι το ChatGPT τού έγραψε ξαφνικά μηνύματα στα πολωνικά, παρότι το χρησιμοποιεί μόνο στα τσεχικά, τα ρωσικά και τα αγγλικά. Κάποιος άλλος ανακάλυψε ότι ένα παράξενο σύμβολο που είχε παρεμβληθεί σε εντολή Linux προερχόταν από τη γλώσσα Κανάντα.
Ποια η σχέση της OpenAI και της Google με το Ισραήλ
Η σχέση της OpenAI με το Ισραήλ δεν περιορίζεται στην εβραϊκή καταγωγή του διευθύνοντος συμβούλου της, Σαμ Άλτμαν, ο οποίος έχει δηλώσει δημόσια ότι είναι Εβραίος. Σε εταιρικό επίπεδο, υπάρχουν αναφορές για χρήση τεχνολογίας της OpenAI από τον ισραηλινό στρατό μέσω της Microsoft Azure. Σύμφωνα με έρευνα του Associated Press, η οποία δημοσιεύθηκε τον Φεβρουάριο του 2025, μοντέλα της OpenAI χρησιμοποιήθηκαν μέσω της υποδομής της Microsoft σε στρατιωτικές δραστηριότητες του Ισραήλ. Η OpenAI δήλωσε ότι δεν έχει συνεργασία με τον ισραηλινό στρατό.
Επομένως, χρειάζεται να διακρίνουμε την προσωπική ταυτότητα των στελεχών, τις επιχειρηματικές σχέσεις της εταιρείας και τη χρήση των προϊόντων της από τρίτους. Η χρήση μοντέλων της μέσω της Microsoft δεν αποδεικνύει από μόνη της άμεση συνεργασία ή πολιτική συμμαχία με το Ισραήλ. Αντίστοιχα, δεν υπάρχουν τεκμηριωμένα στοιχεία ότι η εμφάνιση εβραϊκών λέξεων σε ελληνικές απαντήσεις του ChatGPT συνδέεται με το Ισραήλ ή με την ταυτότητα των ιδρυτών του.
Από την άλλη, η Google διατηρεί ισχυρούς επιχειρηματικούς και τεχνολογικούς δεσμούς με το Ισραήλ, με κεντρικό άξονα το Project Nimbus, μια σύμβαση ύψους 1,2 δισεκατομμυρίων δολαρίων που υπογράφηκε το 2021 (από κοινού με την Amazon) για την παροχή υπηρεσιών cloud computing και τεχνητής νοημοσύνης στην ισραηλινή κυβέρνηση. Παράλληλα, η εταιρεία λειτουργεί μεγάλα κέντρα έρευνας και ανάπτυξης (R&D) στο Τελ Αβίβ και τη Χάιφα, ενώ επενδύει ενεργά στο τοπικό οικοσύστημα νεοφυών επιχειρήσεων, διοργανώνοντας προγράμματα όπως το Gemini Startup Forum για την ενίσχυση ισραηλινών εταιρειών στον τομέα της κυβερνοασφάλειας και των αμυντικών συστημάτων AI.
Η συνεργασία αυτή έχει προκαλέσει έντονες εσωτερικές αντιδράσεις από εργαζομένους της Google και δημοσιογραφικές έρευνες, οι οποίες αναφέρουν ότι τεχνολογίες AI της εταιρείας (όπως το Vertex AI) έχουν ζητηθεί ή χρησιμοποιηθεί από τμήματα του ισραηλινού στρατού για την ανάλυση οπτικού υλικού και δεδομένων. Από την πλευρά της, η Google δηλώνει σταθερά ότι οι υπηρεσίες της προορίζονται για πολιτική χρήση από κυβερνητικά υπουργεία και συμμορφώνονται με τις εσωτερικές αρχές δεοντολογίας της, οι οποίες απαγορεύουν τη χρήση της τεχνητής νοημοσύνης για την ανάπτυξη όπλων ή την κακόβουλη παρακολούθηση.
«Τα παλιά ελληνικά κείμενα χρησιμοποιούσαν εβραϊκό κώδικα»
Ειδικός προγραμματιστής εξηγεί στην Politic ότι η εμφάνιση εβραϊκών χαρακτήρων στα ελληνικά κείμενα είναι ένα καθαρά τεχνικό λάθος στον «εγκέφαλο» της τεχνητής νοημοσύνης. «Το πρόβλημα ξεκίνησε επειδή το AI εκπαιδεύτηκε διαβάζοντας εκατομμύρια παλιές ιστοσελίδες από το ίντερνετ. Πολλά ελληνικά κείμενα από τις δεκαετίες του ’90 και του ’00 ήταν αποθηκευμένα με έναν παλιό κώδικα υπολογιστών, ο οποίος χρησιμοποιούσε τις ίδιες ακριβώς ψηφιακές τιμές (bytes) που χρησιμοποιεί και ο αντίστοιχος κώδικας για τα εβραϊκά. Το AI μπερδεύτηκε, διάβασε λάθος αυτές τις σελίδες και αποθήκευσε στη μνήμη του ελληνικές λέξεις ανακατεμένες με εβραϊκά γράμματα», σημείωσε.
Επιπλέον, ανέφερε ότι το AI είναι σχεδιασμένο κυρίως για να «σκέφτεται» στα αγγλικά. «Όταν του ζητάμε να γράψει ελληνικά, δεν έχει έτοιμες ολόκληρες τις ελληνικές λέξεις στη μνήμη του και αναγκάζεται να τις συνθέσει γράμμα-γράμμα, χρησιμοποιώντας αυτούς τους βαθείς ψηφιακούς κωδικούς. Σε αυτό το επίπεδο, το σύστημα παθαίνει ένα στιγμιαίο βραχυκύκλωμα: χάνει τη συγκέντρωσή του και κάνει ένα τυχαίο μαθηματικό άλμα, επιλέγοντας ένα εβραϊκό γράμμα αντί για το ελληνικό, επειδή για τον υπολογιστή οι δύο αυτοί χαρακτήρες μοιάζουν με τον ίδιο αριθμό».
Τέλος, επισήμανε ότι αυτό το πρόβλημα δεν συμβαίνει μόνο με τα ελληνικά, αλλά επηρεάζει πολλές γλώσσες παγκοσμίως που δεν χρησιμοποιούν το λατινικό αλφάβητο. «Για να το λύσουν οριστικά, οι μηχανικοί της τεχνητής νοημοσύνης αλλάζουν τώρα τον τρόπο που εκπαιδεύουν τα μοντέλα. Χρησιμοποιούν πλέον μόνο σύγχρονους, καθαρούς κώδικες και φιλτράρουν αυστηρά τα κείμενα του διαδικτύου, ώστε οι διάφορες γλώσσες να μην μπερδεύονται ποτέ ξανά μεταξύ τους», κατέληξε.